Ik was dit jaar voor de tweede keer op hetzelfde congres, twee jaar na de vorige keer, en het programma was van binnen veranderd. In 2024 ging het gesprek over onderwijspraktijk: hoe je AI de collegezaal in krijgt, welke tools de licentie waard zijn, of studenten zouden gaan frauderen. Dit jaar, in Wenen, ging vrijwel alles wat ertoe deed over toetsing. Niet over de vraag of AI onze tentamens haalt — die discussie is voorbij — maar over wat die tentamens eigenlijk meten, en of we dat antwoord hardop zouden willen verdedigen.
Meteen een voorbehoud: ik ben één deelnemer op één congres in één vakgebied, en een congresprogramma is geen representatieve steekproef van een discipline. Mijn eigen paper werd dit jaar niet geaccepteerd; dat van een collega die op toetsing werkt wel. Dat is een steekproef van één en ik weet wat die waard is. Maar de indruk bleef hangen, en er zat een argument aan vast.
Toetsing is de hefboom
Het argument is eenvoudig. Je kunt curriculuminnovatie stimuleren zoveel je wilt, en docenten alle ruimte geven om in hun eigen onderwijs te experimenteren. Maar zolang de toetsing de oude competenties, het oude gedrag en de oude leerstrategie blijft belonen, veert het systeem uiteindelijk terug. Toetsing is niet de laatste schakel in de keten. Toetsing bepaalt wat we onder bekwaamheid verstaan, en alles daarvoor — leeruitkomsten, curriculum, hoe studenten daadwerkelijk studeren, waar begeleiders op letten — buigt mee.
Daar hoort direct een tegenwicht bij. Op één van de dia’s stond alleen Outcome Obsessed. Als je onderwijs volledig inricht rond wat meetbaar is, wordt leren platgeslagen tot wat in een rubric past. Dezelfde hefboom die het systeem in beweging brengt, kan het ook vernauwen. De eerlijke vraag is niet hoe we méér meten, maar welk soort leren we zichtbaar willen maken. Die spanning is in Wenen niet opgelost, en dat werd ook niet gepretendeerd.
Never-skilling
Het nuttigste woord dat ik meenam was never-skilling.
Deskilling is wat er gebeurt als een vaardigheid die je al bezit wegzakt door gebrek aan gebruik. Dat is een reëel probleem, maar het is het probleem van de ervaren professional. Het probleem van de beginner is een ander: de vaardigheid ontstaat helemaal nooit. Elke casus komt binnen, het antwoord ligt onmiddellijk klaar, het geleverde werk ziet er prima uit — en de lus waarin expertise groeit, draait geen enkele keer.
Die lus is weinig spectaculair: signalen opmerken, bestaande kennis activeren, twee hypothesen tegen elkaar afwegen, het mis hebben, bijstellen, kennis opnieuw ordenen. Experts zijn niet snel omdat ze meer feiten hebben opgeslagen, maar omdat hun kennis zo geordend is dat klinische signalen die structuren direct activeren. Die ordening ontstaat alleen door de lus te draaien. Vandaar de zin die ik sindsdien blijf herhalen: betere prestaties zijn niet hetzelfde als meer geleerd hebben.
Dat snijdt aan twee kanten. Een AI die het antwoord aanreikt, slaat de vorming van die structuren over. Een AI die doorvraagt — welke signalen wegen hier het zwaarst, wat verandert er als de context verandert — ondersteunt juist de vorming ervan. Dezelfde technologie, tegengesteld effect. Het publieke debat over “studenten worden er dommer van” maakt dat onderscheid zelden.
Twee rijexamens
Wat doe je dan met toetsing wanneer het ingeleverde werk door mens en machine samen is gemaakt? Uit een verslag de onderliggende redenering afleiden werkt niet meer, en juist die gevolgtrekking was de basis van het hele bouwwerk.
De richting waar het veld naartoe beweegt is niet: toetsing zonder hulpmiddelen afschaffen. En ook niet: doen alsof AI er niet is. Het is beide condities toetsen, expliciet. Kom je zonder hulpmiddel tot een verdedigbare conclusie? En, apart daarvan: kun je een goede vraag formuleren, de uitkomst kritisch beoordelen, zien waar die afwijkt van je eigen oordeel, je vertrouwen daarin kalibreren, en aan een collega uitleggen hoe je tot je conclusie bent gekomen?
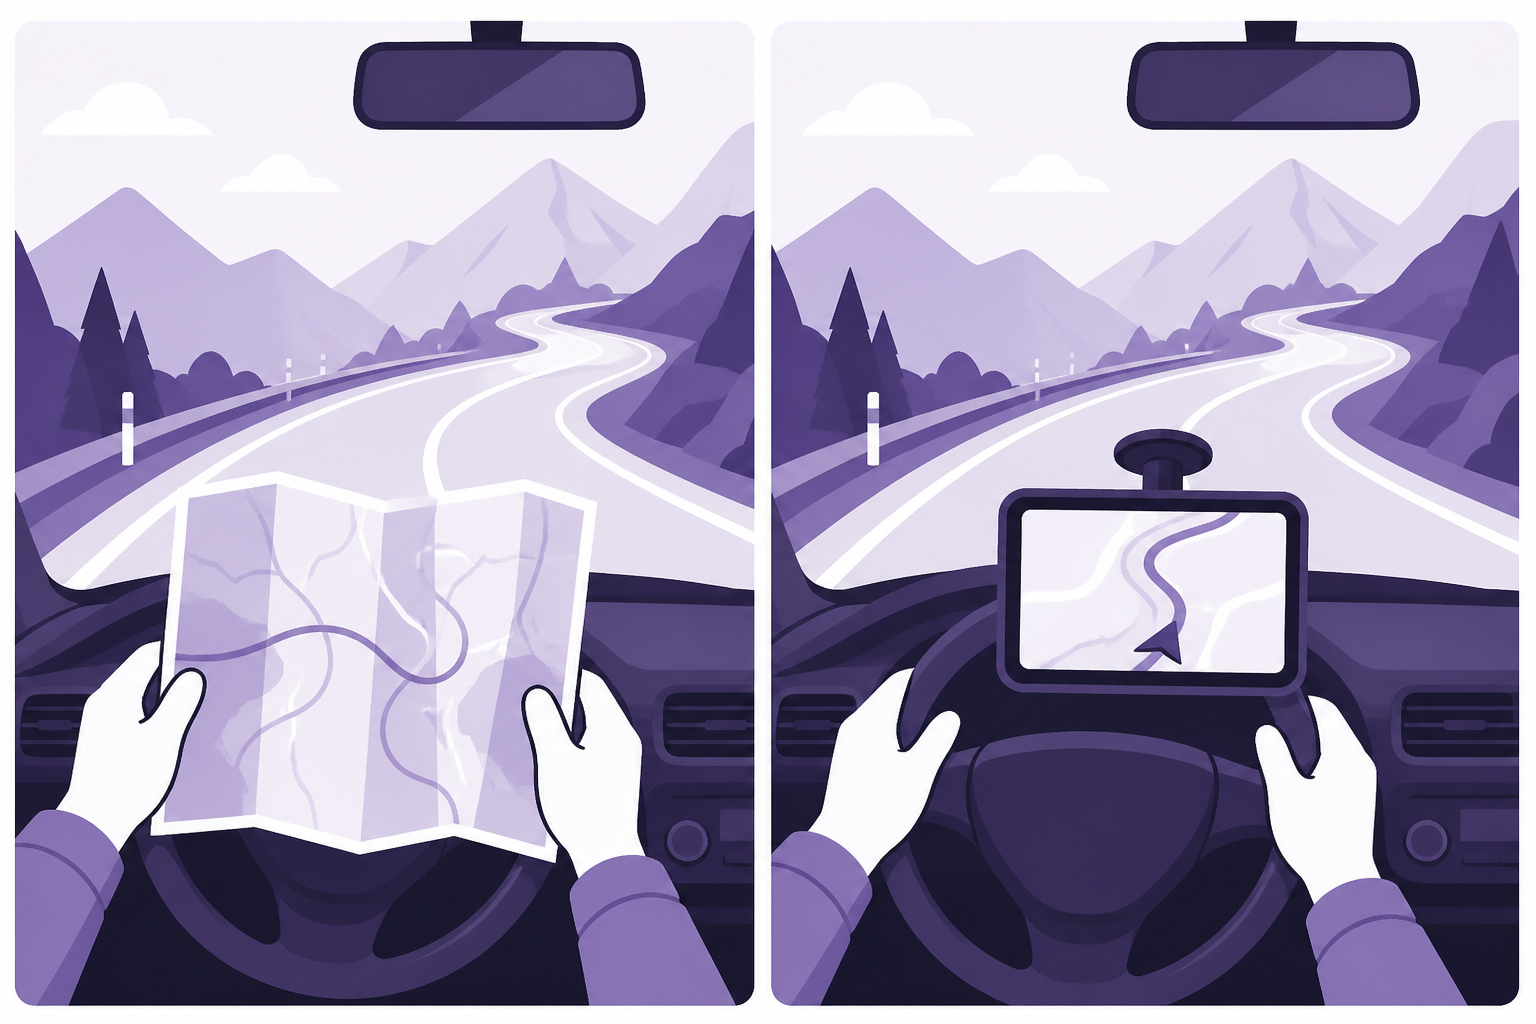
De vergelijking die iemand maakte, was het rijexamen — voor mij de bruikbaarste van de hele week. We willen weten of je zonder navigatie kunt rijden, én of je mét navigatie niet het kanaal in stuurt. Toekomstige bekwaamheid is geen keuze tussen menselijke en kunstmatige competentie; het is bekwaamheid onder beide condities.
Wat nog niet opgelost is
Twee dingen, en ik noem ze liever dan dat ik het nette verhaal verkoop.
Beide condities toetsen kost ongeveer het dubbele, en niemand legde uit hoe een echt curriculum dat betaalt. Bovendien vraagt het beoordelen van de interactie in plaats van het antwoord dat die interactie wordt vastgelegd: een infrastructuurvraagstuk met een privacyvraagstuk eromheen.
En dan het resultaat dat iedereen licht in verlegenheid bracht. De voor de hand liggende oplossing is de student eerst zelf te laten redeneren en pas daarna de AI te laten raadplegen. Een goed principe — maar in ten minste enkele experimenten niet voldoende: deelnemers die hun eigen redenering eerst opschreven, presteerden samen met het model alsnog slechter dan het model alleen. Mens plus AI is niet betrouwbaar beter dan elk afzonderlijk. De relevante eenheid van analyse is het mens–AI-systeem, en hoe je dat goed ontwerpt weten we nog niet.
Dat stelt me eerder gerust dan andersom. Het betekent dat het interessante werk nog voor ons ligt, en dat de mensen die het doen bereid zijn ook de uitkomst te publiceren die hun eigen principe niet vleit.